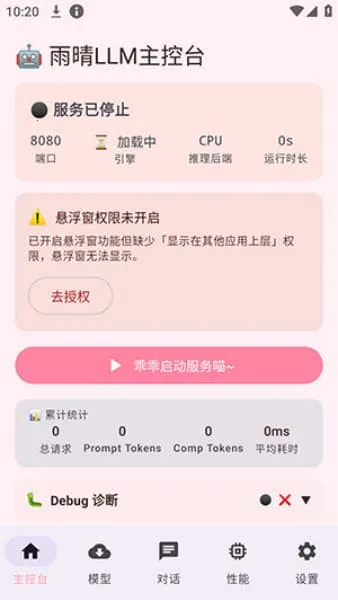
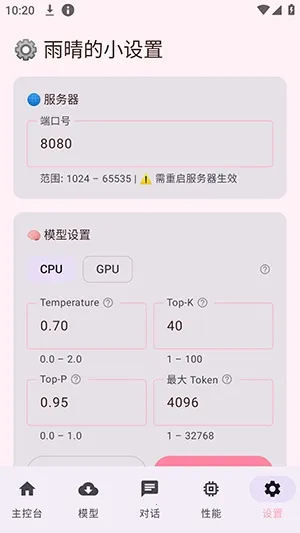
雨晴LLM是运行于Android平台的本地离线LLM推理服务器。支持CPU与GPU推理后端自由切换,有实时性能统计仪表板和可拖动悬浮窗口。提供持久后台服务,模型需单独下载导入。内置网络服务,开放兼容OpenAI规范的API端点。完整兼容标准OpenAI对话接口格式,还能自定义基础推理参数,优化资源调度,支持多客户端接入,方便灵活,助力手机成为家庭离线AI中枢。
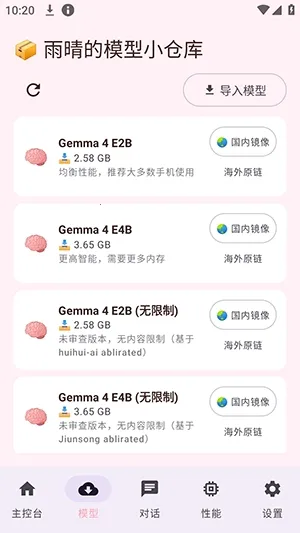
雨晴LLM特色鲜明。支持持久后台服务模式,启动推理服务后可切至后台持续运行,不会因页面退出中断推理任务,稳定为外部客户端持续提供AI接口服务。模型采用独立下载机制,用户按需获取对应量化规格的权重文件导入,不强制捆绑内置模型,灵活平衡存储空间与推理效果。完整兼容标准OpenAI对话接口格式,支持多轮对话上下文参数自定义,几乎无需修改代码,即可将原有云端AI程序迁移至手机本地离线运行。提供可拖动悬浮窗口,无需常驻应用主界面,在任意界面快速启停服务切换模型查看运行日志,多任务并行操作更加便捷高效。
1、安装 APK,授予存储、后台悬浮窗、后台运行权限;
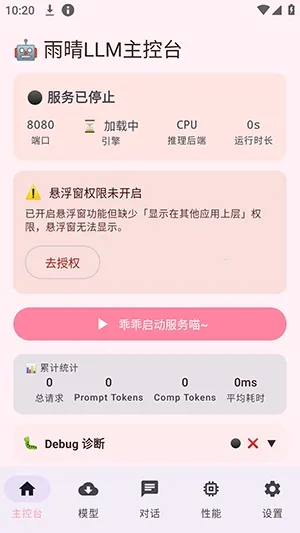
2、进入模型管理页面,下载对应 Gemma量化模型文件;
3、选择 CPU/GPU推理后端,启动本地 API服务;
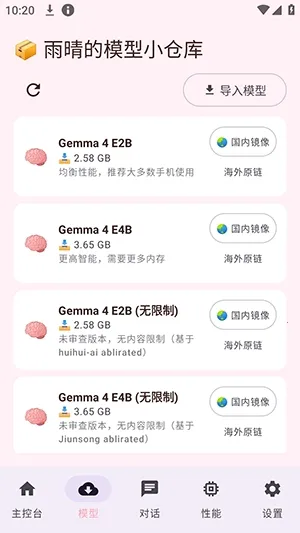
4、使用任意兼容 OpenAI API的客户端,填写本地地址 http://127.0.0.1:8080即可调用;
5、悬浮窗可随时查看生成进度、切换模型、关闭服务。
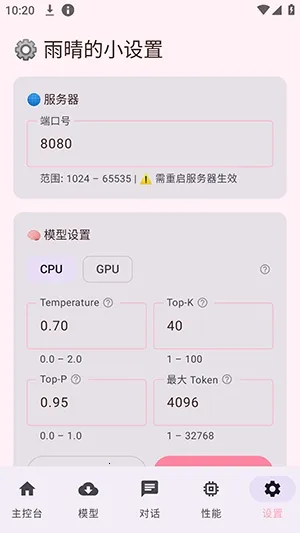
1、支持CPU与GPU推理后端自由切换,能依据手机硬件配置和功耗需求自主选择,兼顾老旧设备兼容性与高性能机型加速推理。
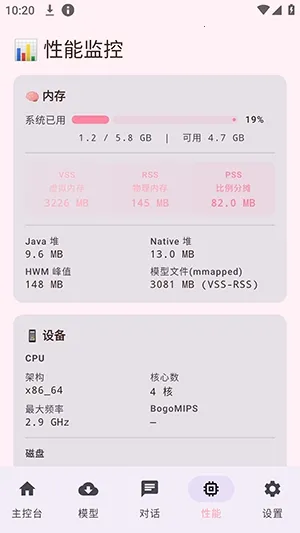
2、配备实时统计仪表板,可视化展示推理速度、内存占用、负载状态等运行数据,方便监控模型运行状态并及时调整。
3、支持持久后台服务模式,启动推理服务后可切至后台持续运行,不因页面退出中断推理任务,稳定提供AI接口服务。
4、提供基础推理参数自定义选项,可调整温度、上下文长度、最大生成长度等配置,适配不同任务需求。
雨晴LLM在运行方面表现出色。它支持CPU与GPU推理后端自由切换,能依据手机硬件配置和功耗需求灵活选择,兼顾不同设备。其配备的实时性能统计仪表板,可直观监控推理负载等运行数据,方便用户及时调整。持久后台服务能力很实用,启动推理服务后可切至后台持续运行,不中断任务。模型独立下载机制也很灵活,用户能按需导入权重文件。另外,它完整兼容标准OpenAI对话接口格式,提供可拖动悬浮窗口,操作便捷。在资源调度上也有优化,减少卡顿闪退,还支持多客户端同时接入,局域网内其他设备可访问,让手机成为家庭离线AI中枢,整体表现令人满意。